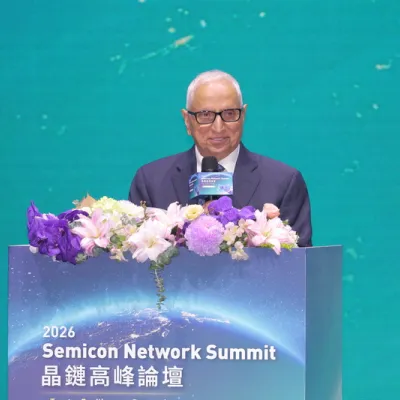
AI模型規模持續膨脹,所需算力已不是一座機房能夠容納。Google AI與基礎架構資深副總裁暨首席技術專家Amin Vahdat(瓦赫達特)今(2)日在SEMICON Taiwan 2026開幕主題演講中表示,Google已透過TPU Superpod、資料中心網路及跨區域廣域網路等三層架構,支援100萬顆TPU共同執行單一工作;其中,光路交換器可在設備故障時即時重新配置網路,將原本可能長達數小時的運算中斷時間縮短至數秒。
Vahdat指出,AI運算所需的網路創新橫跨不同尺度,從晶片內部的奈米級連線、機架與資料中心之間的公尺級網路,一路延伸至跨資料中心、跨洲乃至全球尺度。當數千、數萬甚至百萬顆加速器必須同步處理同一工作,決定效能的不再只是單顆晶片速度,資料能否及時抵達正確位置,也成為限制AI算力擴張的關鍵。
「正是網路讓這件事成為可能。」Vahdat表示,模型參數增加雖能持續降低測試損失、提高模型準確度及解題能力,但模型規模愈大,需要同步參與運算的晶片就愈多,必須依靠更高頻寬、更低延遲且具備故障容錯能力的網路串聯。
第一層:單一Superpod整合9,600顆TPU
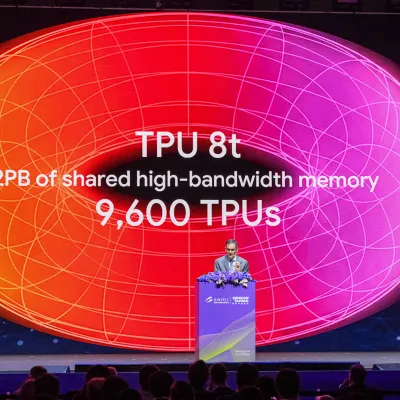
Google三層AI網路架構的第一層,是由TPU 8t組成的Superpod。單一Superpod包含144個機架、9,600顆TPU,透過高速晶片間互連(Inter-Chip Interconnect,ICI)共享2 PB高頻寬記憶體,並提供121 Exaflops運算能力。
Vahdat表示,這9,600顆TPU不是各自執行獨立工作,而是以接近奈秒的時間尺度進行協調,同步處理同一項大型訓練任務。TPU 8t採用3D Torus(三維環狀網路)架構,每顆TPU分別連接前後、左右及上下方向的相鄰晶片,使資料能夠沿著不同方向在整個Superpod中傳遞。
Google也將相當於一台中型乙太網路交換器的網路功能整合進每顆TPU,讓運算核心與網路更靠近,以降低延遲及電力消耗。Vahdat指出,資料搬移已是晶片與資料中心最主要的能耗來源之一,網路設計若無法降低傳輸距離,再多運算單元也可能因等待資料而閒置。
256面微型反射鏡改變光路 故障中斷縮至數秒
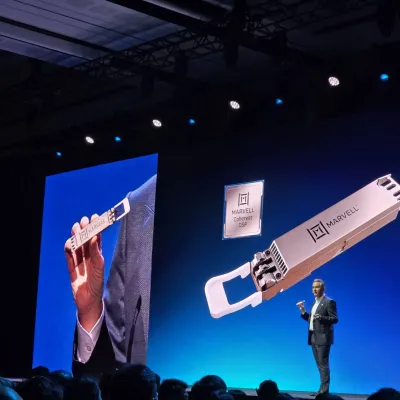
為串聯144個機架,Google把每個機架的光纖連接至中央光路交換器(Optical Circuit Switch,OCS)。一套光路交換器約包含256面微型反射鏡,集中在約一根手指大小的晶片上,並透過馬達控制反射鏡的三維角度,將輸入光線導向指定輸出埠。
與傳統封包交換器不同,光路交換器不必進行光—電—光轉換,也不需要逐一處理網路封包,因此本身耗電量僅以瓦計算。系統還能以程式控制反射鏡方向,動態改變不同機架間的實體連線。 (相關報導: Google要把TPU送上太空找電!Project Suncatcher採太陽同步軌道,探索太空AI算力 | 更多文章 )
當機架、晶片或網路元件故障時,Google可即時重新配置拓撲,把故障元件排除在運算路徑之外,讓系統在數秒後繼續運算;相較之下,若必須立即停機並等待人員完成實體維修,即使在理想狀況下也可能中斷數小時。