「認知注射戰」的媒體遮蔽工具中,最困惑人的就是民調。讀者現在可以只用 1 分鐘,在計算機上按 3 下,就能夠驗證並發現:
第一、當前坊間民調宣稱的誤差,沒有 1 個是正確的,同時理解如何得到正確的民調數據。
第二、近期坊間民調的平均誤差約為 ± 5.44% ,個別機構的最大誤差可達到 ± 12.85% 。常發表民調的機關,有 2 家誤差高於全體,為「(改組前的)美麗島」與「求真」。
第三、坊間民調不正確,可能是無意因缺乏知識與能力導致;也可能是故意扭曲或完全作假,讀者可以進一步根據客觀資訊自主判斷。
第四、民調並非只有電話調查,許多公開數據都反映了真假民意,譬如最近的「爺爺 1 歲打共匪」事件,讀者可以發現周邊數據中很多隱藏的事實與社會中更多抄寫剪貼的錯誤觀念。
樣本 1067 人,誤差為正負 3% ,係金 A ? 坊間民調最令人困惑的就是都有一句:「本調查樣本 1067 人,誤差為正負 3% 」。這句話哪裡來的?是不是事實?
樣本數與調查誤差之間的關係,必須在「隨機 / 等機率樣本」的前提下才能存在。「隨機」一詞給人「隨便」的誤會,其實是相反的「絕不能隨便、必須每一個樣本在相同機率下被抽中」;實務上就是被抽出的樣本不能更換,如果更換,積極或有閑的人會被增加抽中的機率,而謹慎或很忙的人,會被換掉而失去聲音,必然造成整體樣本扭曲。
這 2 個數字又是在「二項分配」限制下,才會發生的參數,科普語言就是:限定只有 2 位候選人, 2 人獲票率合計必須為 100% ,而且 2 人獲票剛好都是各 50% 。
當前坊間民調都任意更換樣本,且最少更換 12 輪以上,不是「隨機 / 等機率樣本」。
坊間民調報告還有 1 個「未答」欄位,相當還有另外一個名叫「未答」的人。同時,即使只有 2 位候選人, 2 人也都不是各得 50% 。
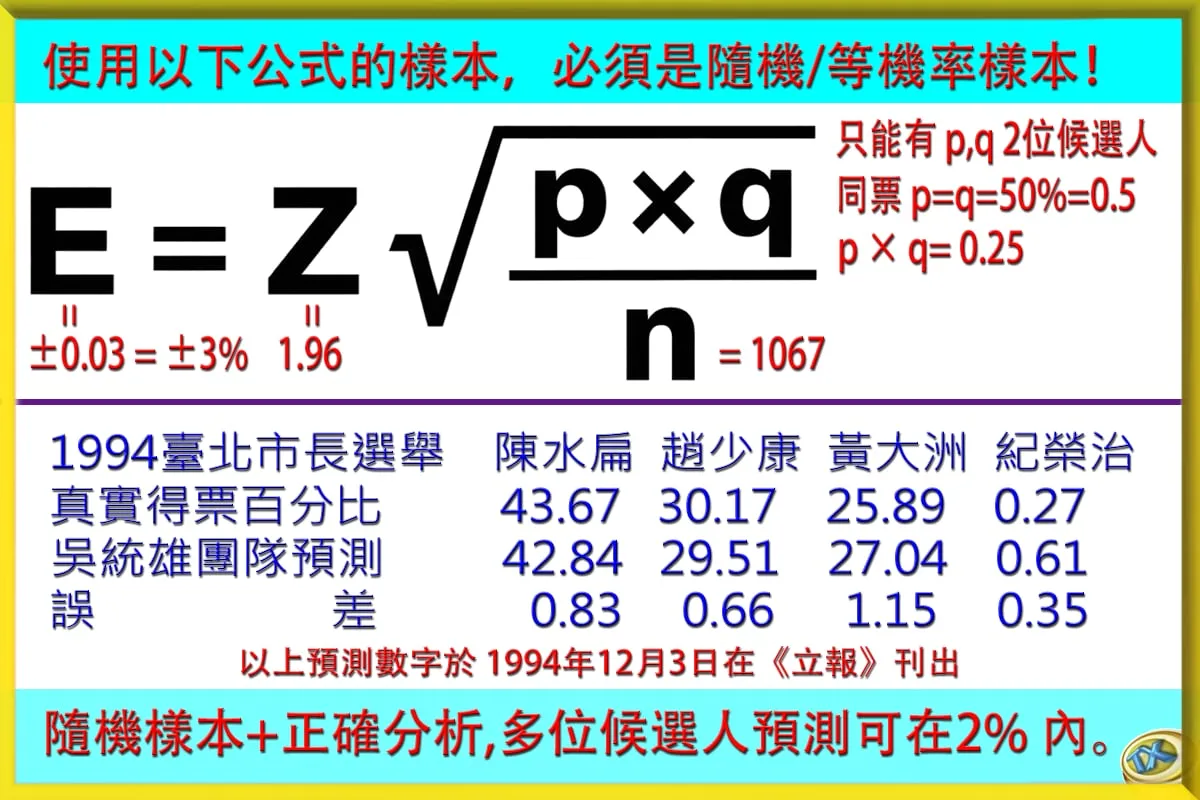
計算機按 3 下,馬上驗證 這個公式真正的意思為:只有 2 位候選人,在真實選舉中獲票相同各為 50% ,但樣本可能無法呈現各為 50% ,如果經由「隨機 / 等機率抽樣方法」,將顯示 2 人得票在 47%~53% 之間,樣本數值高的那一位,並不見得在真實選舉中獲勝,有輸的可能。公式解說如下。
p 和 q ,就是限定只能有 2 位候選人,且必須獲票各為 50% ,兩者相乘得到 0.25 。
Z ,就是坊間民調宣稱的「信賴區間 / 信心水準」 95% ,其對應的值是± 1.96 。
請你獨立查核,沒有一家符合這 5 個標準 現在就請讀者在計算機上按 3 下,先 0.25 除以 1067 ,再開方,最後乘 1.96 ,你就得到 ± 0.03 ,也就是± 3% 。
各位讀者在 1 分鐘內已經完全解開了民調的奧秘,由於 E 和 n 在等號的兩端,與誤差有關的 5 個值,只要有一個不是本專欄指出的特定值,任何一個值改變,都絕不可能同時出現: n=1067 , E=0.03 。
讀者們立即可以獨立查核,當前所有坊間民調,你會發現沒有一家符合這 5 個標準,也就是沒有一家真正瞭解抽樣調查的原理,與執行正確的抽樣、訪問、分析程式。因為現在民調公司都使用同一個調查資訊系統,當初放了一張「萬用報告」,而對任一個案都是錯的。
人類認知以「大家說」為優先,但深層仍然存在著實驗意識而待啟發,恭喜讀者今天可以經由實驗而做出正確獨立判斷。
正確做法誤差可在 2% 內, 40 年如 1 日 民調只要遵守「隨機 / 等機率樣本」原則,與依照事實設定各參數,即使在多候選人時,仍然可以獲得近似預測,如自附圖中自 1994 年臺北市長選舉,迄本文作者退休前各屆選舉,誤差均在 2% 以內。
1994 預測曾事先公開,後來因委託約定,不得向媒體發表,但也均事先告知當事人:如柯文哲、連勝文、丁守中…本人或其核心人士。
以 1994 年為例,也回應趙少康最近炒熱度,與當年首度出現「棄保論」,成為名嘴愛講的迷思,到底如何分析有無棄保事實,另題再論。
計算機按3下,解開民調奧秘,自主判斷民調虛實。同時理解為何多位候選人預測,誤差仍可全部在2%以內。
統合分析可得坊間平均誤差:± 5.44% 如果做不到「隨機 / 等機率樣本」,統計無法獲得正確參數時,就會採用鄰近參數,而可以用「統合分析」取得。
平時的民調,無法排除高比例的戰術民調,惟總統大選的封關民調,較與民調機構的聲譽有關,人為炒作會較收斂,故可作為階段性參數。
當前最鄰近的數據,就是 2024 的總統大選的 15 家封關民調。亦即在大家的方法都差不多、使用同一個資訊系統,沒有刻意作假的假設下,各家的誤差應該也差不多,可經由「統合分析」獲得坊間民調的平均誤差。
本專欄《初選三策:等機率調查、統合分析、願賭服輸》已經報告過當前的坊間民調平均誤差約為± 5.44% 。
這也說明,為何坊間民調問題不少,但有不少機構宣稱可正確預測,以 2022 大選為例, 3 組候選人的真實得票,兩兩相差都在 7% 以上,這麼大的真實差距,當然可以包涵± 5.44% 的方法誤差。
科學民調的價值,應在候選人真實差距極為接近,或能偵測出極少發生的短期震盪改變,如本調查團隊在 2000 年大選,「 319 槍擊案」所發現不到 2% 以內的改變。請參見《總統槍擊事件與選後衝突 -- 哀社會行為科學能防患於未然,而不可為也》(政治大學社科院 )。
誤差超過平均:改組前的美麗島、求真 「統合分析」不僅可觀察出使用相同工具者的平均誤差,也可反過來發現偏差顯然大於平均的機構,有 2 家:「(改組前的)美麗島」與「求真」。
這 2 家不是一次性的偏差,《全民查假會社》曾經多次請我在《看懂民調》專欄中,解說偏差民調的研究方法問題,這 2 家多次被主編選中討論,詳細清單在: https://seantxwu.pages.dev/RwdBlackPool/index.htm
黨媒「蟑螂民調」有前科、作假「民調蟑螂」正當行 坊間民調如故意扭曲或完全作假,就是「蟑螂民調」,以打擊對手、詐騙讀者為目的。好一點的是只調查篩選後的樣本;狠的是根本沒做,直接做假,這在「三大黨媒」中是已經發生過的事實。當初還在報面吼叫要提告揭露者,但怕被法院(當時還有 51% 公信力)認證為作假媒體,也就不了了之。
(相關報導:
風評:沈伯洋大贏17%─連民進黨都不敢置信的「民調」
|
更多文章
)
還有一些擅於打自己知名度的個人,遊走於各民調機構之間,長期收受利益而不實,不過還是會被業主發現,多次被開除或請走,可稱之為「民調蟑螂」。
「預期效用」戰術:把勝負差距拉得非常大 臺灣正在經歷所有意圖獨裁、或復辟階級統治政權都曾經採用過,對人民「認知注射戰」的考驗。竊用國家資源進行假演戲、假影片、真動員、假造勢…各種手段,在納粹宣傳頭子戈培爾的「全面戰爭運動」中全部實施過了,但有兩點不同。其一有「毒矮子」之稱的戈培爾只向親隨透露他的意圖;而「紅熊」沈伯洋深得毛共「陽謀」的真傳,主動在《鏡傳媒》上公開宣示收取境外勢力金錢,壓制國內言論自由與資訊流通。
其二,戈培爾時代還沒有以「蟑螂民調」,自民調問世起,就已經出現「戰術民調」,開始只是誘導,造成法國等制訂選前不得公佈民調的法律,後來我國也跟進。
17% 是客氣,蟑螂曾拉到 48.8%
接著各國有人依據「預期效用論」運作,使政治投入感沒有那麼強的選民,如果感覺自己支持的人不可能當選,就會放棄投票,
既然要製造「預期效用」,就要把勝負差距拉得非常大,譬如最近轟動的「 17% 」,這是客氣了,未來無法排除拉到「 48.8% 」。
這不是舉例,更不是開玩笑。上一屆臺南市長選舉,正是同一隻蟑螂曾公佈謝龍介將輸黃偉哲「 48.8% 」,最後實際得票兩人差距為 5.1% 。由於臺南市綠營的密度與熱度較高,民調蟑螂就毫不掩飾的作假近 10 倍,企圖把坊間所謂的中間選民,其中稍微偏向謝龍介的,誤認謝沒有機會而全部扒光。
爺爺 1 歲打共匪, 2 個驚人數據、 2 種可能真相 民調只是「大數據分析」中基於隨機理論的一種,當前網路上經常出現各種數據,讀者都可以進行自主分析。
最近發生「爺爺 1 歲打共匪」事件,上周數據顯示:製造這個可笑宣傳的貼文,其按讚 9K 、留言 1K ;而首先揭穿他說謊的社團,按讚數 684 、留言 85 ;這個龐大差距是什麼意思呢?有 2 種可能。
第一種這是自然與真實的數字。一面倒支持領導,喊出「爺爺 1 歲打共匪」就要讚美、就要呼應的人群,比能夠看出不合邏輯者多 13 倍!占本案參與者的 93% ?
我 40 年研究發現「族群統治意識型態者」有 25% ,但會自然拉高到 93% 嗎?有可能是事實嗎?
第二種就是這個數據是「認知注射戰」與「媒體遮蔽」的成果之一,這種成果無法排除與灑下去做假的錢成正比!是不是偷人民的納稅錢,去洗人民的腦呢?
不僅民調數字,身邊各式各樣,根本沒注意到的數字,都可能虛實待辨。今天讀者經由實驗,自己驗證民調的虛實,敬請舉一反三,發現周邊數據被隱藏的更多事實。
學霸學閥、抄寫剪貼 前文提到,坊間民調也宣稱「信賴區間 / 信心水準」 95% , 95% 這個數字其實與誤差公式無關。這個觀念是本專欄《闢二聲:第二類知識 和聲者仍須努力》所介紹統計開拓者小闢二聲和倪曼共同發現與定義的。
公式中的 Z 是指信賴區間 (confident interval) ,其絕對值在此是 1.96 。如果看常態分配曲線,就是 X 軸上± 1.96 的寬度,寬度上方使用積分所獲得的面積,創始者原稱為「信賴程度」( degree of confidence ),二戰後,統計從被打壓,翻身變顯學, George Snedecor 寫出經典教科書,改命名為信心水準 (confidence level) ,在此條件下的曲線面積約占總面積的 95% 。
本專欄曾指出,不知道微積分如何知道曲線面積?如果不知道解決這種相對簡單問題的思想方法,如何能夠解決複雜千萬倍的公共事務問題?這又是一個例證。
70 年前有人翻譯統計教科書,把「信賴程度」誤解為「信賴區間」,只有少數專書如《電話調查:理論與方法》更正了這項錯誤。而許多教科書仍然保留了誤解。能夠賣教科書的都是學霸學閥,也可反映這些霸閥對知識真諦並無興趣,只抄寫剪貼熱衷追求霸閥之名。
今天願花 1 分鐘、臺灣成長靠你扛 臺灣現在無法避免這次「認知注射戰」與媒體遮蔽的考驗,人類天性有 40%~75% 的人群不會採用實驗去認知事物。但有 15% 的自主選民,如果有機會得知,會採用理性抉擇。