
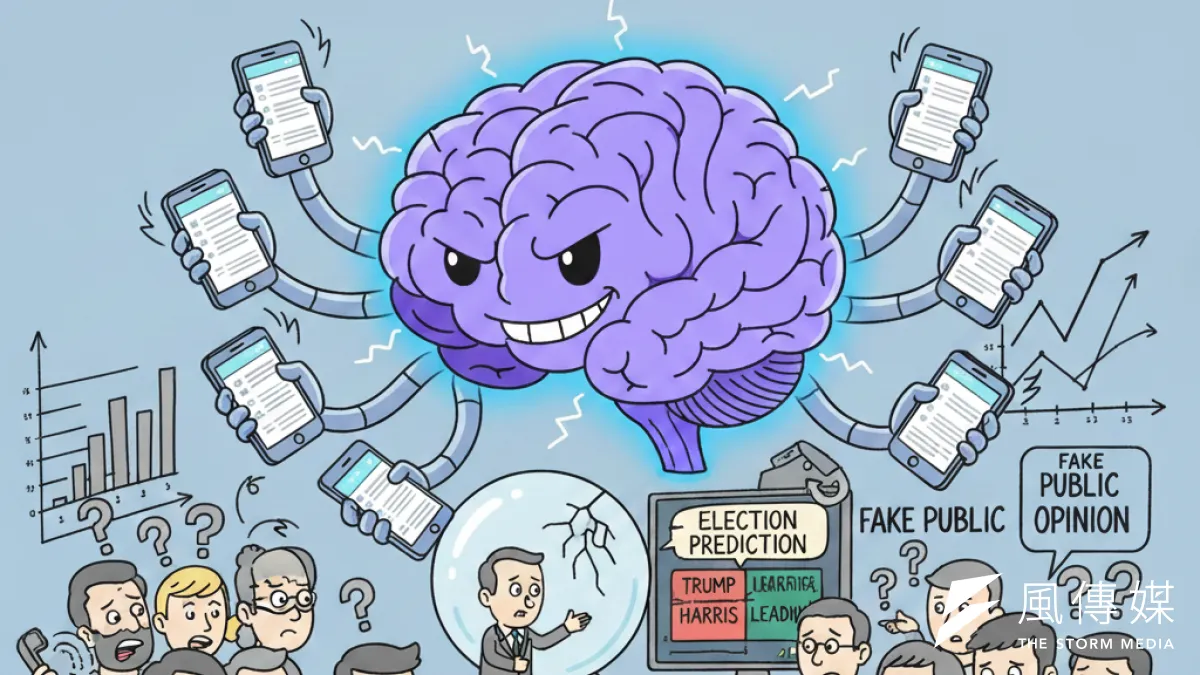
選戰進入倒數,這陣子打開新聞,除了市話民調與手機民調,又多了一種新面孔,叫AI民意模擬,也有人稱矽基民調。
新北、台北、桃園、台中、高雄、新竹縣都有人做,支持度、好感度、勝選看好度一應俱全,有的還細到行政區、投開票所。報告上寫著兩萬多名受訪者,卻沒有一個真人接過電話。這些數字從哪裡來,值得一步一步拆開看。
第一步是造人。先在電腦裡造人。研究單位依照縣市選舉人的結構,按性別、年齡、行政區、學歷與政黨傾向的比例,用大型語言模型生成虛擬選民。
以新北市為例,有一份報告依二十九個行政區配出2萬6771個AI代理人;新竹縣的版本,則參照十三個鄉鎮市與2024年的政黨票結構來配置。
政黨傾向抓哪一次選舉當基準,就決定了這座虛擬城市一開始的藍綠底色。
第二步是寫人設。替代理人寫身世。光有年齡、性別還不夠,研究團隊會替每個代理人寫入社會經歷、媒體使用習慣,甚至分裂投票與拒答傾向,有的報告列到二十八項屬性。
翻成白話,就是設定這位阿伯每天看哪一台新聞,會不會市長投藍、議員投綠,接到民調電話會不會直接掛掉。台灣地方選舉離不開派系、宗親、宮廟與農漁會人脈,這些若沒寫進去,代理人就少了地方政治最重要的一塊骨架。
第三步是灌輿情。餵新聞再逐題作答。系統把截至某一天的新聞與社群聲量餵給代理人,讓它們讀完再逐題回答問卷,觀察接收新聞前後的立場變化。
進階一點的作法會讓代理人彼此影響,模擬里長、鄰居、LINE群組怎麼把一則消息在基層傳開。傳播學講了半世紀的兩級傳播,在這裡被寫成了程式碼。
第四步是開票。從村里往上加總。代理人先判斷會不會出門投票,再決定投給誰。AI每次回答都帶有隨機性,通常要反覆重跑,再把結果由里、行政區往上加總,就成了媒體上看到的各區領先幅度。
另一派作法乾脆不讓AI扮人,改用中選會歷屆逐里開票紀錄、內政部戶籍與財政部所得資料,推估每個里的投票結構。兩種都被叫做AI民調,底層邏輯卻差很多。
最要緊的是對帳。第五步是校準,拿真實選票或真人民調來比。國內有報告拿電話民調的區間來對照,強調模擬結果落在區間之內,可是那些區間動輒相差一、二十個百分點,要落在裡面並不困難。
更值得細讀的是報告上的一行小字:這是代理人的普查模擬,不適用抽樣誤差,只存在模型與情境設定的系統性偏差。代理人做兩萬個或二十萬個,只要人設與模型本身偏了,偏差就原封不動留在數字裡,樣本數大,只是讓結果看起來比較精密。
美國皮尤研究中心9月30日公布的實驗,正好提供一面鏡子。
研究團隊替約一萬五千名真實受訪者各建一個AI分身,連七十一題政治態度都餵進去,近三百題比下來,平均仍差12.4個百分點,換一個模型,誤差也跟著換了樣貌。真人回答不確定的比例,約是AI的四倍。放到台灣,這個問題更棘手,九合一選舉的未表態選民常有兩、三成,那群還在猶豫的人,正是AI最不會演的人。 (相關報導: 風評:沈伯洋大贏17%─連民進黨都不敢置信的「民調」 | 更多文章 )
媒體轉述時,問題又多一層。報告裡那行非真人抽樣的說明,在轉傳過程中往往最先消失,最後留在標題上的,只剩某某領先幾個百分點。對新聞工作者而言,標題至少該寫明模擬兩個字,內文交代代理人數量、資料截止日與研究單位,讓讀者知道這組數字背後站的是模型。