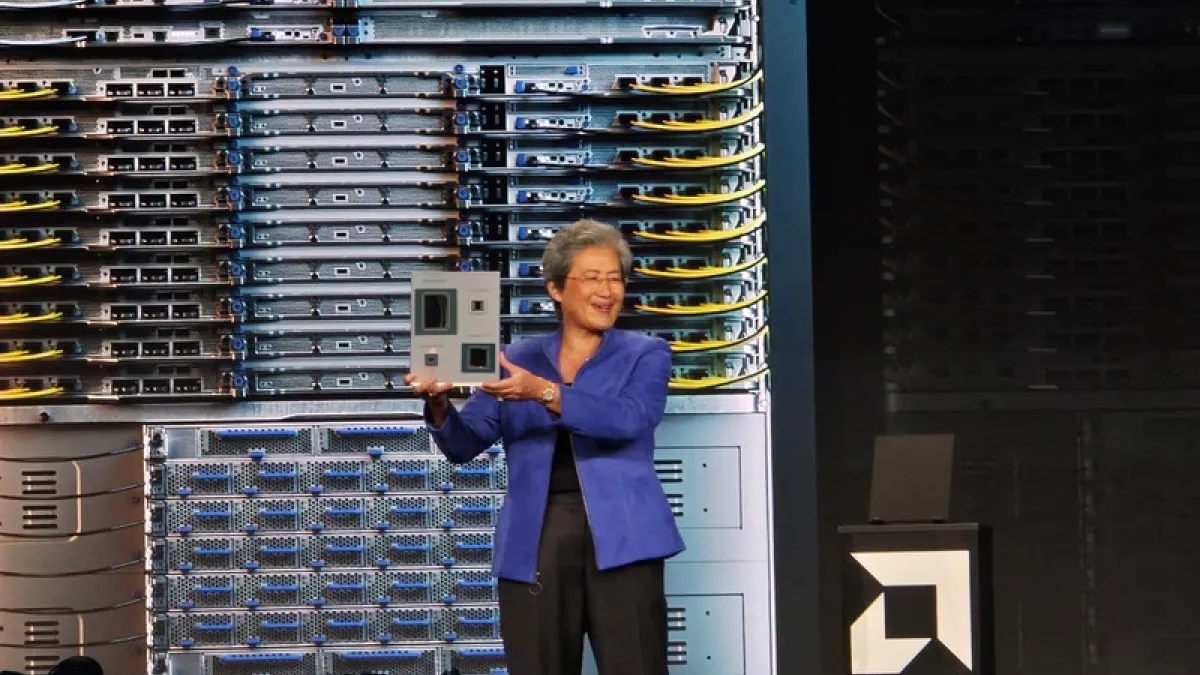
9月21日,AMD股價大漲9.6%,市值首度跨過1兆美元。市場看見它正從晶片供應商走向完整AI系統:Helios機架級平台將GPU、CPU、網路與軟體整合起來;輝達(NVIDIA)則早已從GPU、NVLink、Spectrum-X一路延伸到CUDA與AI Factory。博通協助雲端業者打造客製化XPU及Ethernet網路,華為也以昇騰晶片、CANN軟體與自有互連架構建立AI運算體系。競爭的單位,已由一顆晶片擴大到整座AI工廠。
當各家公司都開始蓋AI工廠,新的瓶頸也浮現了:晶片算得愈來愈快,資料卻未必送得夠快。
GPU蓋得愈多,AI城市愈容易塞車
如果把AI工廠想成一座快速擴張的城市,GPU就像一棟棟摩天大樓,HBM是緊鄰大樓的高速倉庫,互連網路則是道路與鐵路。
過去幾年,產業忙著興建大樓。從H100、Blackwell到Rubin,每一代GPU都把算力往上推;AMD、Google、亞馬遜、Meta與華為也持續增加AI晶片。可是大樓增加十倍,道路若沒有同步拓寬,上班時間整個城市都會塞車,AI現在碰到的正是這個問題。
一顆GPU可以算得非常快,10萬顆GPU一起工作卻完全是另一回事。大型模型訓練時,每顆GPU都必須不斷交換資料、同步參數。只要網路塞住,昂貴的GPU就只能停下來等資料。
所以輝達發展NVLink、AMD推動UALink、博通押注Ethernet,大家其實都在解決同一道問題:如何讓10萬、甚至100萬顆AI晶片,像一顆晶片般共同工作?大家開始替自己的AI城市修路。
銅線是高速公路,光互連是高鐵
然而,道路本身也有極限。今天晶片與伺服器之間的大量資料傳輸仍依靠電訊號。短距離下,銅線便宜、成熟,就像城市裡的高速公路。但城市愈來愈大、貨物愈來愈多,全部依靠卡車跑高速公路,效率終究會碰到瓶頸。
高速電訊號也是如此。傳輸速度愈快、距離愈長,訊號損耗、功耗與散熱問題愈嚴重。當AI資料中心走向數萬、數十萬顆GPU,搬資料本身就開始消耗大量電力。於是AI城市開始蓋高鐵,這條高鐵就是光互連(optical interconnect)。
光可以承載大量資料,在高速與較長距離傳輸下具有能源效率優勢。真正值得注意的趨勢,是光正在一步一步往晶片靠近。這也是CPO(Co-Packaged Optics,共封裝光學)快速升溫的原因。
CPO,把高鐵站蓋到晶片旁
傳統光模組通常位於交換器面板。資料離開交換晶片後,要先透過PCB以電訊號走一段「公路」,到了光模組才轉成光。CPO可以理解成把高鐵站直接搬到交換晶片旁邊。
資料離開晶片不久,就從電轉成光,縮短高速電訊號需要行走的距離,再利用光纖進行大量資料傳輸。概念其實很簡單:既然電愈走愈辛苦,就讓資料早一點搭上光。
(相關報導: 張瀞文專欄:從韓劇掀蓋機到iPhone Duo─三星20年「摺疊夢」,會被蘋果收割嗎? | 更多文章 )
最早是資料中心之間用光,接著機櫃之間大量用光;未來隨著AI運算密度提高,光還可能繼續往封裝甚至晶片靠近。因此,AI下一場硬體戰爭的問題已經逐漸浮現:光最後會走到離GPU多近?