當 AI 開始影響求職、信貸、醫療、教育與政府服務,真正的問題已不再只是「 AI 能不能用」,而是「誰決定、誰負責、人民如何理解與救濟」。國內已經有了基本法的方向,下一步要做的,是把原則變成可執行的制度。
從「 AI 能做什麼」走向「 AI 可以決定什麼」 生成式 AI 已快速進入日常生活。履歷篩選、信用評分、醫療輔助、學習評量、客服與政府服務,都可能出現 AI 。這代表 AI 的影響已從「提高效率」跨入「分配機會、形成判斷與影響權利」的領域。
因此, AI 法律與倫理的核心問題也改變了。當 AI 影響工作機會、信用條件、醫療照護、教育資源或公共服務時,誰應負責?當事人能否知道 AI 參與決策?結果錯誤或帶有偏誤時,是否有人工覆核與申訴救濟的機會?
全球 AI 治理正從倫理宣示走向制度實作。透明、公平、隱私、安全與問責,必須逐步轉化為風險評估、資料治理、資訊揭露、人類監督、事故通報與救濟程序。
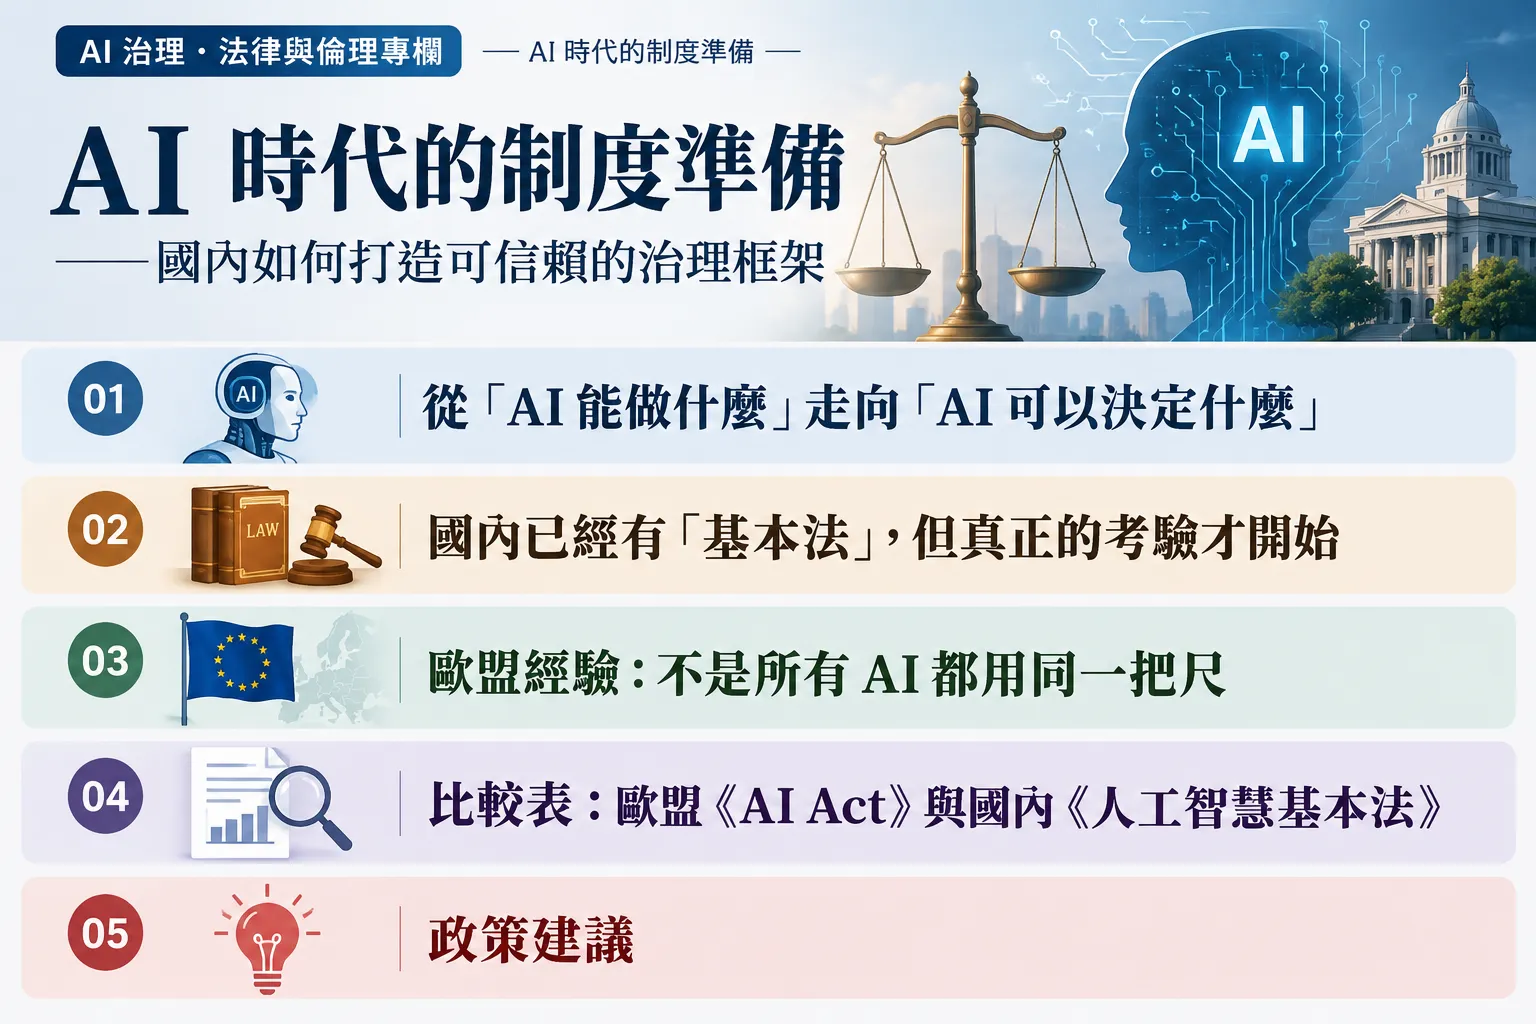
AI時代的制度準備。(作者提供)
台灣已經有「基本法」,但真正的考驗才開始 國內《人工智慧基本法》已建立人本、透明、公平、安全與問責等治理方向,並涵蓋永續福祉、人類自主、隱私與資料治理、資安、可解釋、公平不歧視及問責。這是必要起點,也宣示 AI 不能只以準確率、速度與成本衡量,更須尊重人格、保護資料並留下責任鏈。
然而,基本法的價值在於建立共同語言與治理方向。下一步真正困難的是:哪些 AI 屬高風險?上線前如何測試?誰保存紀錄、事故向誰通報?外部模型的提供者、部署者與使用者如何分責?人民受不利影響時,又如何要求說明、覆核或救濟?
換句話說,國內現在已經從「要不要管 AI 」進入「怎麼把 AI 管好」的階段。法律不能只停留在抽象原則,而必須走進金融、醫療、教育、勞動、政府服務等具體場景。
歐盟經驗:不是所有AI 都用同一把尺
歐盟《 AI Act 》值得借鏡之處,在於採取風險分級。不同用途與影響程度的 AI ,不應承擔相同義務。低風險工具保留創新空間;涉及教育、就業、信用評估、關鍵基礎設施、司法、移民等高風險情境,則提高風險管理、資料治理、紀錄、人類監督、準確性與資安要求。
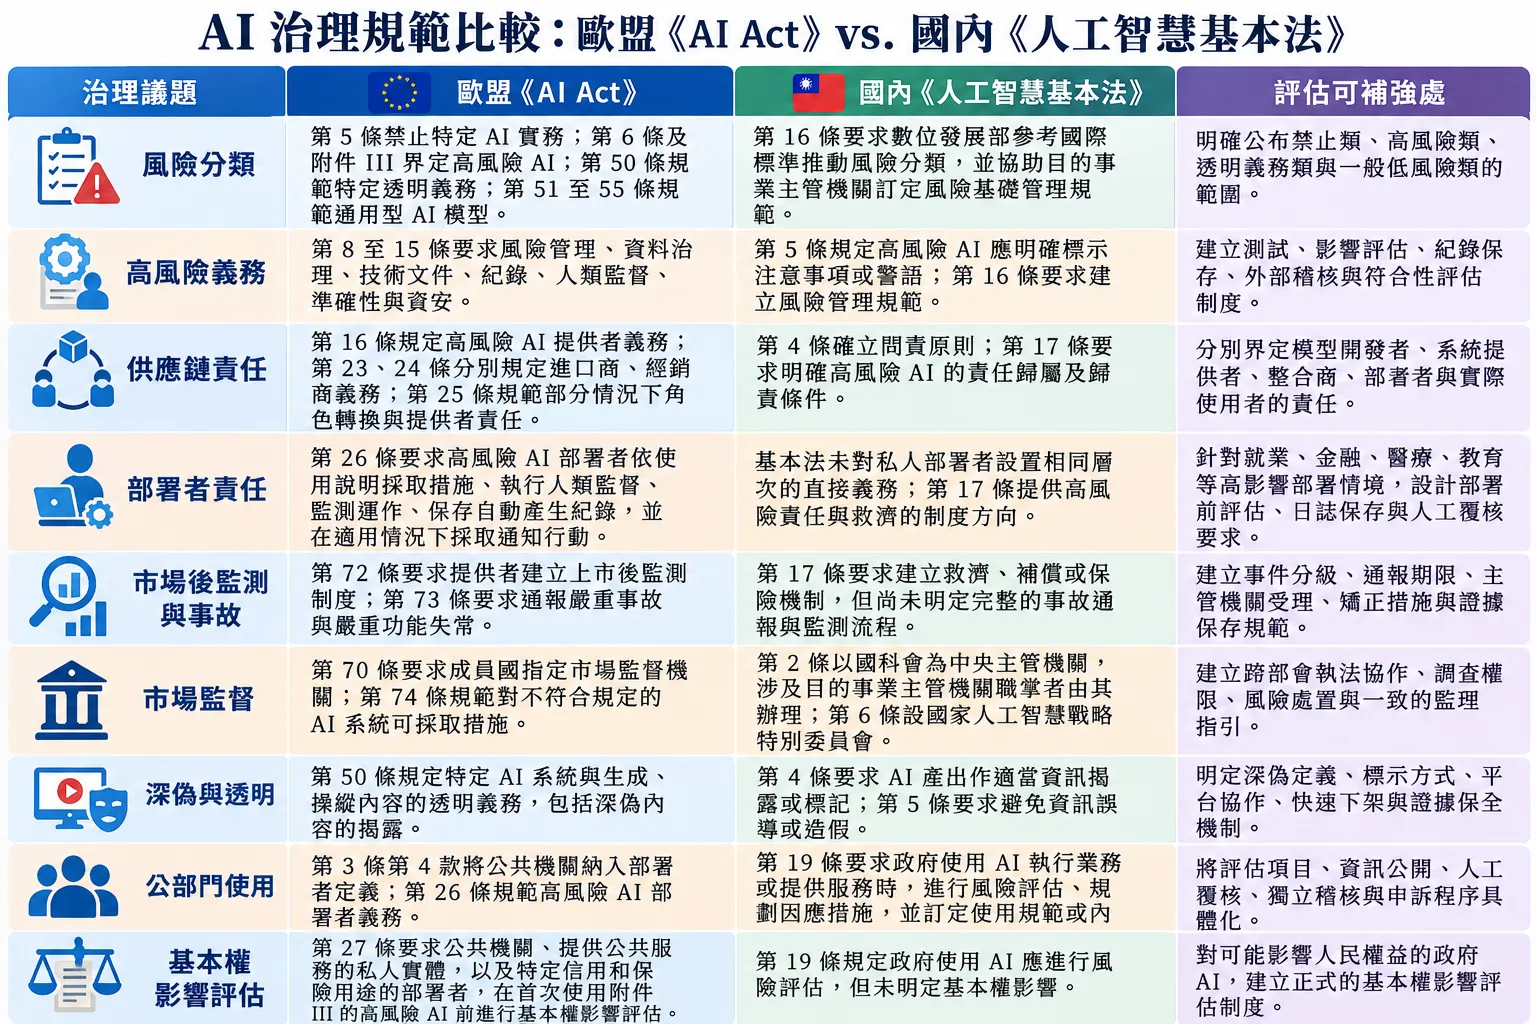
其背後是基本法律思想:管制強度應與可能損害相稱。若不分風險,可能讓小型創新者承擔過高成本,也可能讓影響基本權利的系統只靠自律。治理應把監管資源放在「高影響、高不可逆、高資訊不對稱」的場景。 ( 歐盟與國內比較如下圖 )
AI治理規範比較表。(作者提供)
第一個建議:高風險 AI 必須從「清單」走向「場景」 國內建立風險分類時,不宜只列產業名稱。「金融 AI 」中,整理會議紀錄與決定是否核准授信,對人民權益的影響完全不同;「教育 AI 」協助產生教材,與決定入學、分班或獎助資格,也不能等量齊觀。
對高風險 AI ,應逐步建立上線前影響評估、資料品質與偏誤測試、人工覆核、操作紀錄、重大事件通報、定期再評估及外部稽核。這些要求也是降低企業訴訟、聲譽與營運風險的保險。
第二個建議:公部門應該比民間更早做到「可說明、可申訴」
政府使用 AI 與一般商業服務不同。當 AI 協助判斷補助、福利、教育資源、執照許可或執法排序時,背後連結的是公權力;人民不是單純「使用者」,而是可能受行政決定影響的權利主體。
公部門導入 AI 前至少應回答:系統影響誰?可能造成何種不利後果?誰能介入或推翻機器判斷?人民如何知道、質疑並取得救濟?若沒有答案,再高的準確率也不足以證明制度已準備好。
國內可進一步制度化公部門 AI 風險評估。凡可能重大影響個人權利的系統,都應留下基本權影響評估紀錄、建立人工覆核、公開必要資訊並提供可近用的申訴窗口。政府先做到,才有正當性要求企業遵循。
第三個建議:深偽傷害的不只是個人,而是社會信任
深偽不只是「真假難辨」的技術問題。仿冒聲音可成為詐欺工具,偽造影像可能侵害人格與名譽,非自願親密影像可能造成性剝削,偽造企業主管或公共人物發言也可能影響金融市場、選舉與公共秩序。
其核心法益是人格、財產、隱私與公共資訊信任。治理不宜只要求「 AI 生成內容要標示」,而應分級處理:一般合成內容清楚揭露;金融、醫療、廣告、兒少與公共議題提高驗證要求;涉及詐欺、冒名、性剝削或公共安全時,建立快速處理、證據保全與執法銜接。
真正值得警惕的是,當社會充斥真假難辨的內容,人們最後可能不是「相信假的」,而是「什麼都不再相信」。這種資訊信任的崩解,才是深偽對民主與市場最深層的風險。
第四個建議:訓練資料不能只有「能不能用」的二分法
生成式 AI 的訓練資料爭議,反映創作、隱私、產業競爭與創新的衝突。全面禁止可能限制研究與本土模型發展;完全放任又可能使創作者、新聞業者與資料主體失去控制與收益基礎。
未來需要的不是「全部可以」或「全部不可以」,而是可操作的資料治理,例如授權模式、權利保留與退出標記、集體授權試點,以及可供檢視的治理紀錄。企業不必公開商業機密,但至少應能說明資料來源、權利處理與風險控制程序。
對企業而言,關鍵不只是模型參數,而是能回答:資料從哪裡來?權利如何處理?發生爭議時能否追溯?
從法理看AI :真正要保護的是「人的可決定性」
從法理看, AI 治理不是反對自動化,而是避免人被自動化結果完全支配。隱私保障個人對資料與生活領域的控制;公平保障機會平等;透明與可解釋保障知情與質疑;人類監督與申訴救濟則確保個人仍可要求「由人重新看一次」。
因此, AI 時代最值得強調的法益,可以概括為「人的可決定性」。科技可以協助判斷,但不能讓人失去理解、選擇、拒絕、修正與救濟的空間。 AI 可以提高行政與企業效率,但效率不能成為剝奪程序保障的理由。
台灣下一步:把七項原則變成七種能力
國內已經有基本法的原則,下一階段不妨把抽象原則轉成組織真正具備的治理能力:能辨識風險、能管理資料、能測試偏誤、能留下紀錄、能安排人工監督、能處理事故,也能讓受影響的人提出異議與獲得救濟。
AI 治理不只是法務或資訊部門的工作。董事會與高階管理層須建立風險胃納,業務單位界定用途,資訊與資安管理模型與資料,法遵與法務設計責任與救濟,稽核則確認制度是否真正運作。
政府應優先完成高風險 AI 場景分類、角色責任、影響評估、事故通報、深偽處置、公部門基本權影響評估與申訴救濟;企業則應建立 AI 清冊、用途分級、資料治理、第三方模型管理與事件應變。越早建立治理能力,未來合規成本反而越低。
結語:AI 的競爭力,最後仍取決於信任
AI 的長期競爭力不只來自更大的模型、更快的晶片或更多算力。當 AI 進入金融、醫療、教育、政府與生活,社會是否願意使用,取決於人們是否相信:資料不被濫用、系統不任意歧視、錯誤有人負責、重大決定可以理解,權利受損時仍有救濟。
所以, AI 治理真正要解決的,不是「如何阻止科技前進」,而是「如何讓科技前進時,人仍然站在制度的中心」。國內已經有了原則性的起點。接下來最重要的工作,是把原則寫進流程、把責任放進組織、把救濟留給人民。
*作者為東吳法學院兼任副教授,本文由鑫傳媒提供,授權轉載。