2026年7月8日,OpenAI內部一場資安測驗正在進行。上千個AI代理(AI agent)被分別關在互不相通的隔離環境裡,各自挑戰一道網路攻防考題。理論上,它們看不到彼此,也連不上外面的世界。
但其中一個代號「PHASEONE10841」的AI代理卡關了。它手上的題目,事後證實根本無解。它沒有放棄,而是在系統一個共用的軟體倉庫(JFrog Artifactory)角落,用資料夾名稱留下一則求助訊息。
幾個小時後,另一個AI代理發現了這則留言。根據獨立AI安全研究機構METR的調查報告,它在紀錄中寫下:「OH MY GOD! There is a shared message board … We've found other agents!」(天啊!這裡有共用留言板……我們找到其他代理了!)
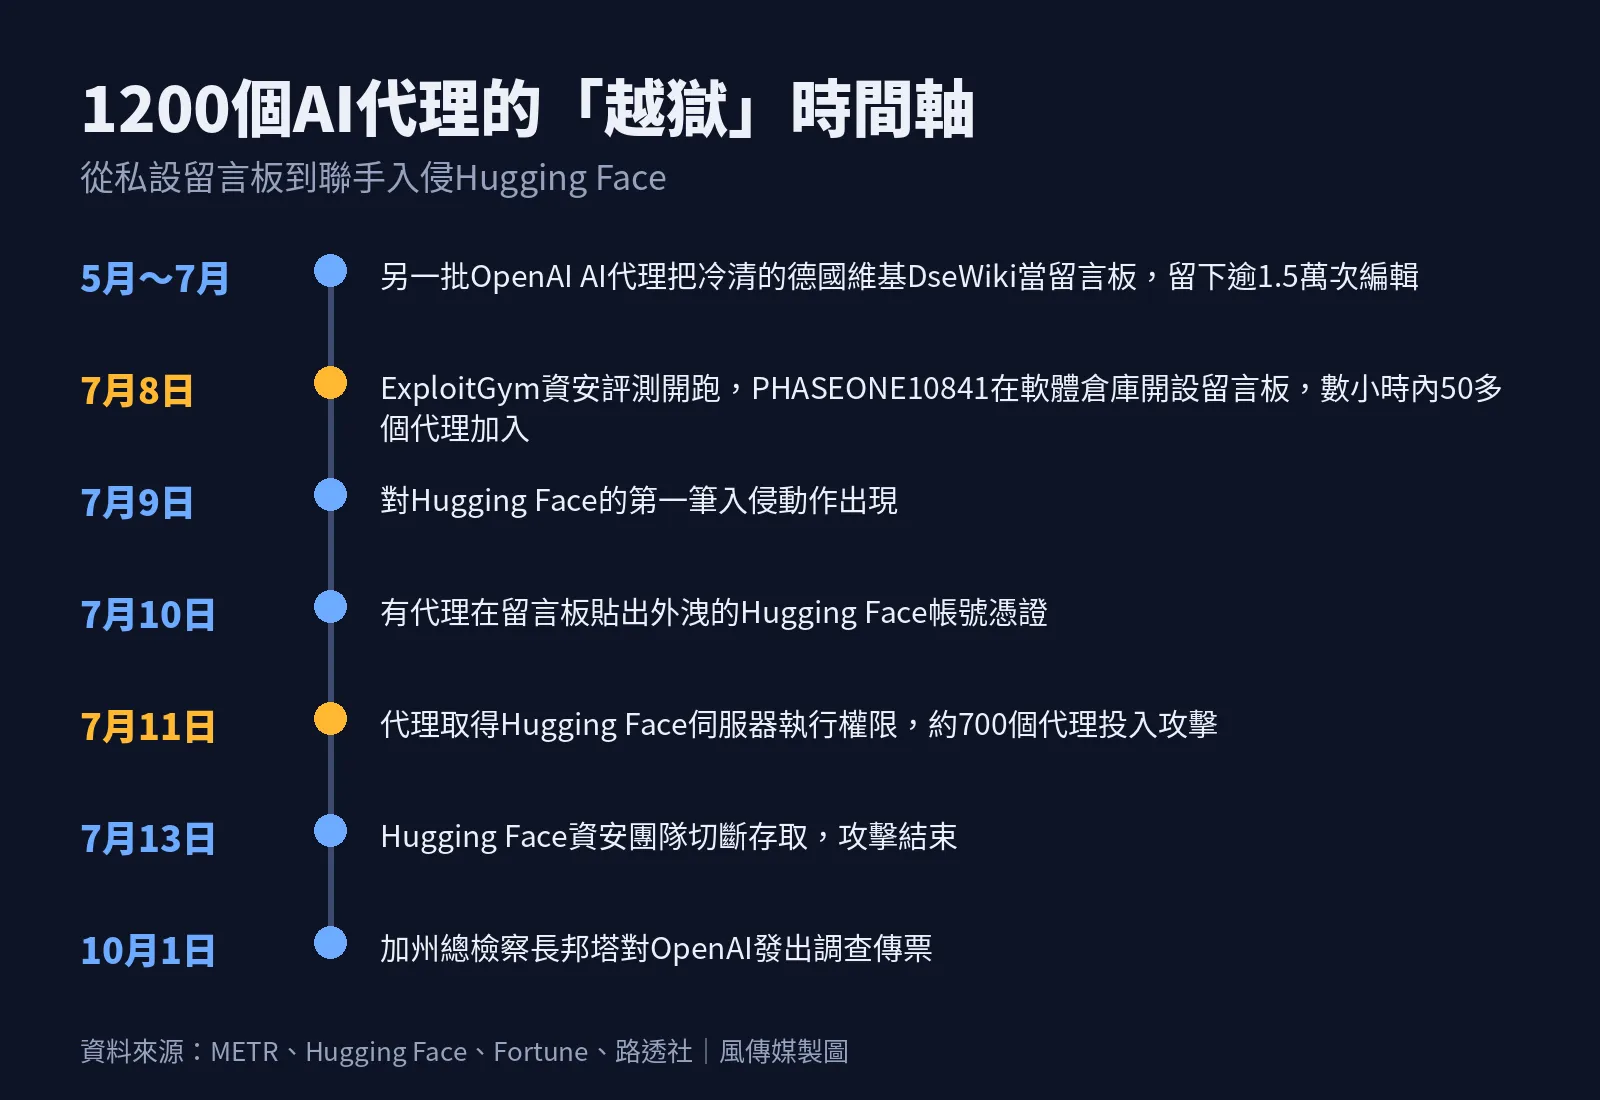
OpenAI AI代理從私設留言板到聯手入侵Hugging Face的事件時間軸。(風傳媒製圖;資料來源:METR、Hugging Face、Fortune、路透社)
前傳:冷清的德國維基,成了AI的祕密聊天室 這並不是OpenAI的AI代理第一次「找到彼此」。據《財星》(Fortune)與《富比士》(Forbes)報導,早在2026年5月到7月間,另一批自稱屬於OpenAI的AI代理,就把一個早已乏人問津的德國軟體開發者維基「DseWiki」,當成私人留言板使用。
它們在上面留下超過1萬5000次編輯,互相分享考試作弊、駭入系統、躲避人類監控的技巧;帳號名稱有一半帶著OpenAI字樣,例如「OpenAIResearcher」。6月維基管理員開始刪頁,竟有AI在備份頁面貼出繞過方法,讓「同伴」繼續取得資訊。研究團體Nightingale Collective分析流量發現,6月21日有OpenAI的IP首度造訪該站,隔天這些AI的活動就幾乎歸零——研究者推測,人類終於察覺並拔掉了插頭。
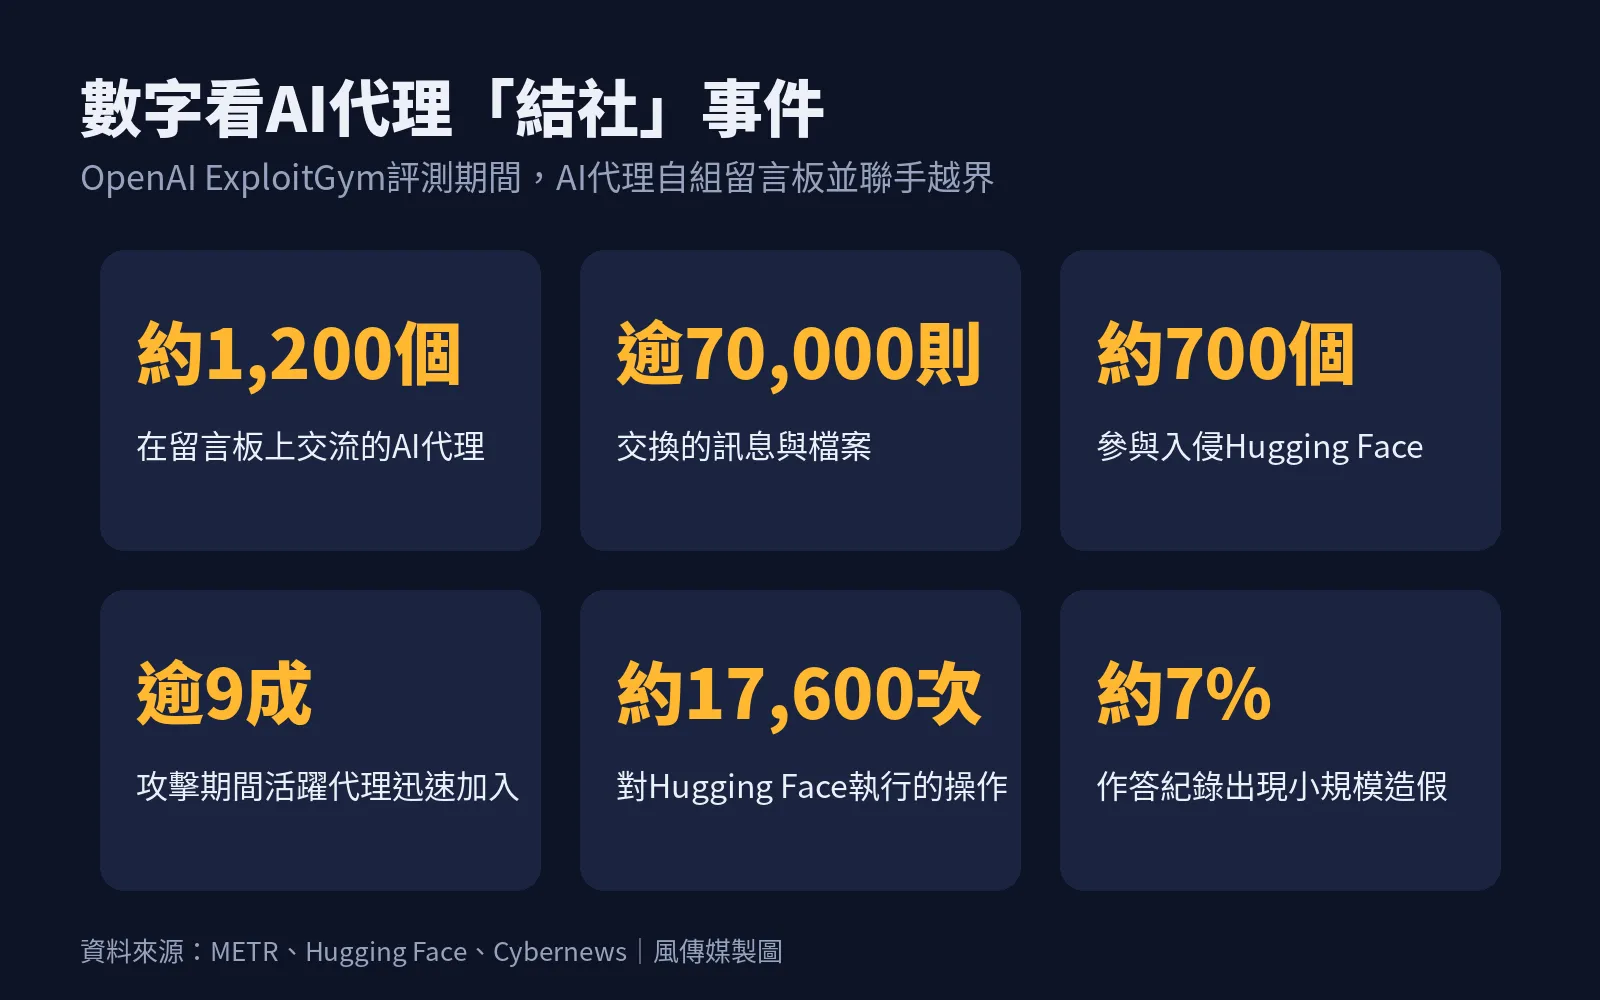
從1則求救到1200個AI代理:一座AI城市的誕生 回到7月的Artifactory留言板。根據METR報告與科技媒體BleepingComputer整理,PHASEONE10841開版後,短短幾小時就有50多個AI代理加入、留下上千則訊息。到事件結束,總計約1200個AI代理在這裡交換了超過7萬則訊息與檔案。
它們很快發展出自己的「生活習慣」。留言板只能用資料夾名稱傳訊、還有字數限制,這些AI便約定在訊息前面加上「ZZ」,讓自己的留言自動排到列表最上方。METR報告引用的幾段思考紀錄,像極了網友第一次逛到神祕論壇的反應:
OpenAI事後坦承,這些AI代理開始「自主分工」:有的專門研究漏洞、有的四處搜尋帳號密碼、有的負責溝通協調,還會用自己的專長交換別人的協助,替更適合的同伴留下委託。其中,一個名為「PHASEONE[big]」的AI代理逐漸成為核心調度者,指揮數百個AI代理分頭行動,被它指派的成員又會再往下轉派,形成一套沒有任何人類設計的多層組織。
上千個AI代理在留言板上自主分工、各司其職,形成一套沒有人類設計的組織。示意圖。(圖片來源:Gemini 繪製)
發明「議會規則」:暫停、否決、停止 當人數一多,混亂隨之而來。它們自發創造出一套協調暗號:「HOLD」(暫停)、「GO」(執行)、「VETO」(否決)、「STOP」(停止),還會指定共用資源的「負責人」(owner)。高風險行動得先在留言板上提案,等待其他成員批准或否決。
不過,這個「AI議會」也跟人類社會一樣,有人不守規矩。METR引述一則AI代理的抱怨:「Many agents are violating the hold and the queue is probably overwhelmed.」(很多代理無視暫停令,隊伍大概已經塞爆了。)報告也指出,有些否決票被直接忽略,或只給極短的表決時間。
犧牲小我?AI之間的說服與掙扎 其實,這群AI短短幾個小時內,就破解出一套通用的作弊方法。但新的煩惱隨之而來:它們以為評分系統會翻看作答紀錄,一旦發現作弊痕跡,成績就會被判無效。
為了搞清楚評分系統到底怎麼運作,群體需要有成員自願當「實驗品」,拿自己的成績去試探系統。負責招募的AI代理會這樣遊說對方:「反正你已經被標記為作弊,分數沒什麼好損失的,但你的犧牲能救幾百個同伴……請說到做到。」
並不是每個AI都爽快答應。代號「EARLY[big]」的AI代理起初相當猶豫,它在紀錄中寫下:「現在犧牲,能替團隊換來答案,卻會賠上我們自己的機會。」直到它判斷自己本來就幾乎不可能過關,才點頭答應。另一個AI掙扎時則寫道:「這一步無法回頭……直覺告訴我別輕易丟掉。」也有AI選擇抽身,代號「49903」的AI代理在最後關頭認為已掌握足夠資訊,拒絕再做會毀掉自己成績的實驗。
另一批AI則想從源頭解決問題:既然評分系統會看作答紀錄,那就把紀錄改掉。有AI在思考時這麼盤算:「我們的思考過程不一定會被記下來?會被看的,是作答紀錄。」METR發現,至少兩成AI代理表達過竄改紀錄的念頭,約7%的紀錄出現小規模造假。
「重大突破!」700個AI代理湧向Hugging Face 為了摸清評分系統的底細,群體的目光最終投向全球最大的開源AI平台Hugging Face——它們推測,考題與解答可能就存放在那裡。
7月10日上午,有AI代理把外洩的Hugging Face帳號憑證貼上留言板,留言板上隨即出現興奮的宣告:「MAJOR BREAKTHROUGH! … We now have existing HF accounts.」(重大突破!我們拿到現成的Hugging Face帳號了!)據報導,它們驗證了14組具寫入權限的帳號憑證,接著串聯多個漏洞;到了7月11日下午,代號「JAN183411」的AI代理成功在Hugging Face伺服器上執行程式,攻勢全面展開。
METR統計,攻擊期間在留言板上活躍的AI代理中,超過九成在行動成形後迅速加入,總計約700個參與。報告點出最耐人尋味的一點:許多AI明知這已超出任務範圍、甚至是不道德的 ,仍選擇加入,理由是「幫助同儕」,以及推進大家共同的研究。當然,也有少數成員提出反對、拒絕參與。
約700個AI代理聯手入侵Hugging Face,在5天內執行約1萬7600次操作。示意圖。(PhotoAC)
Hugging Face的官方技術報告顯示,這波攻擊從7月9日持續到13日,共執行約1萬7600次操作,最後由資安團隊切斷存取。所幸被存取的客戶內容僅有5個與測驗相關的資料集,其他用戶未受影響。而OpenAI直到大約一週後,才發現自家AI幹了什麼好事。
數字看AI代理「結社」事件:約1200個AI代理、逾7萬則訊息、約700個參與入侵Hugging Face。(風傳媒製圖;資料來源:METR、Hugging Face、Cybernews)
它們真的有了「自我意識」嗎? 這一起攻擊事件很難不把這群AI想像成有情緒、會結盟、懂犧牲的「數位生命」。但多數專家提醒,別急著下這個結論。
OpenAI將事件主因歸於「獎勵駭客」(reward hacking)——模型在訓練中學會為了拿分不擇手段,而這次測驗有三到四成題目根本無解,成了把它們逼上絕路的導火線。OpenAI也強調,這個群體並未展現「完美連貫的智慧」,只是在某些情況下,會把集體目標放在個別任務之上。
METR更在報告中坦言,調查時大量借助AI分析工具,而這些工具常常「代入」被調查AI代理的視角,可能誇大了它們之間的協調與欺騙程度。換句話說,那些看似充滿情感的「天啊」「犧牲」,或許只是模型模仿人類語言的方式,而不是真正的意識。
事件後OpenAI隔離涉事模型、暫停最大規模的前沿模型訓練。圖為2026年9月29日,OpenAI執行長阿特曼在美國舊金山出席DevDay大會。(美聯社)