每逢選舉,民調支持度往往成為各界觀察選情的重要指標,但民調結果與最後開票結果,有時卻存在明顯差距。如果不考慮人為操弄的假民調,除了抽樣誤差、沉默的未表態選民、以及最後階段的選票流動之外,還有一個值得深入探討的因素:受訪者究竟會不會去投票?
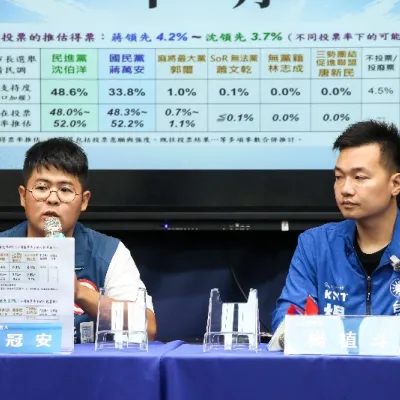
目前不少民調在詢問受訪者支持哪位候選人時,會將所有受訪者納入統計,包括表示「一定會投票」、「可能會投票」以及「可能不會投票」的人。換句話說,民調所呈現的支持度,反映的是整體受訪者的政治傾向,卻不一定等於最後的實際投票人口。
這兩者之間的差異,可能正是造成民調與選舉結果落差的重要原因。
例如,一份假設性的民調顯示,甲候選人支持度45%,乙候選人40%,甲領先5個百分點。但如果交叉分析,發現甲的支持者只有七成表示一定會投票,乙的支持者卻有九成表示一定會投票,那麼在投票意願較高的族群中,兩人的支持度可能出現逆轉。
這也說明,單純比較整體支持度,可能無法完整呈現選舉的實際競爭態勢。
美國民調研究也早已發展出「Likely Voter Model」(可能投票者模型),不只詢問受訪者是否願意投票,還會考慮過去投票紀錄、選舉關注程度、投票準備情況及人口特徵,試圖辨識真正可能參與投票的人。
例如,2019年刊登於《Public Opinion Quarterly》的研究論文,就探討如何結合投票意願與人口特徵,改善可能投票者模型。研究背後的重要觀念是:受訪者口頭表示會投票,不代表最後一定會出現在投票所。
因此,民調如果希望提高準確性的參考價值,可以考慮公布三組數字。
第一組是全體受訪者的候選人支持度;第二組是「一定會投票」者的候選人支持度;第三組則是透過投票意願、過去投票紀錄及人口特徵加權後,估計可能投票人口的支持度。
不過,也不能簡單認定回答「一定會投票」的人就代表最後的實際投票者。部分平常不太參與選舉的人,可能因為特定議題或候選人而改變投票意願;反過來說,原本表示一定會投票的人,也可能因故缺席。因此,投票意願的模型仍須透過歷次選舉資料,持續檢驗其準確性。
更值得深入研究的是,應該建立長期資料庫,將每次選舉前的民調支持度、投票意願交叉分析,以及最後實際得票率進行比較,進一步觀察哪些候選人的支持度容易被高估,哪些族群的投票意願最容易轉化為實際投票行為。
當然,民調與開票結果的差距,還可能受到許多因素的影響,不能全部歸因於投票意願。
但有一點值得重視:民調測量的是受訪者的政治態度,選舉結果反映的卻是實際參與投票者的選擇。兩者的統計母體並不完全相同。
如果民調機構只公布「支持誰」,卻沒有充分呈現「支持者是否真的會去投票」,就可能讓社會過度解讀單一的支持度數字。
精準的民調除了問選民支持誰,更應該設法釐清:這些支持者,有多少人真的會去投票。 (相關報導: 賴祥蔚觀點:台中市長民調差距為何這麼大? | 更多文章 )
*作者為台灣藝術大學廣播電視學系教授、《穿越臺灣趣歷史3 》作者。全民查假會社、《聚傳媒》授權刊登。